Submitted by admin on 2018, June 14, 9:24 AM
问题的提出
我们知道,在单机的“线程模型“中,2个线程并发修改一个变量,是需要加锁的。这个在Java并发编程–序列1已经讲过,要么是悲观锁,要么是乐观锁。
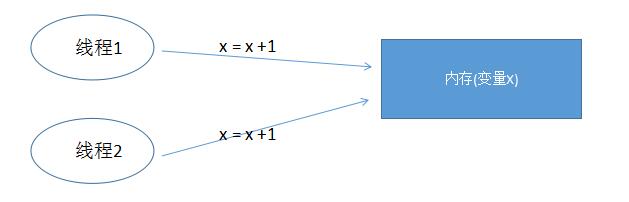
如果把单机的线程模型,改成有客户端/服务器的进程模型。服务器可以是Mysql/Redis/Memcached任何一种,那该问题又如何解决呢?
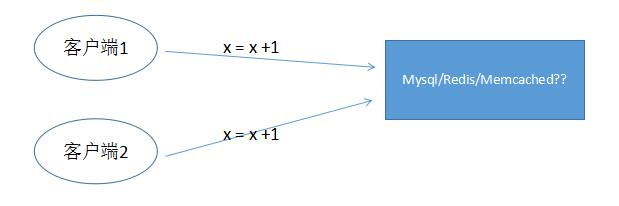
方案1 – 单条命令的原子性
Mysql: 用类似update table set x = x + 1 where … 这样的单条语句就可解决上述问题,因为服务器内部会处理加锁的问题,不用客户端解决。
Memcached: incr/decr命令
Redis: incr/decr命令
一句话:对于这种简单的整数加减的原子操作,只要是1条命令可以搞定,就不需要客户端解决互斥问题。
方案2 – Memcached/Redis的乐观锁
上面的方案1,必须是单条命令,但该方法有很大局限性。很多时候,如果我们需要执行复杂的计算逻辑,要先把数据get出来,执行复杂逻辑,再set回去。类似下面这种:
x = get(key) 对x执行复杂逻辑 set(key,x) x = get(key) 对x执行复杂逻辑 set(key,x)
此时有2条指令,没有办法保证2条语句的原子性,这个时候如何解决呢?
Mysql的乐观锁
关于Mysql解决上述问题的乐观锁方案,此处不再详述,参见Java并发编程-序列1
Memcached乐观锁
Memcached提供了2个命令 gets + cas。gets取出数据的时候,同时返回版本号;修改之后, cas回去的时候,会比较该版本号和服务器上最新的版本号。如果不等,则cas失败。
Redis乐观锁
Redis提供了watch命令,如下所示:
watch key1 multi set key1 foo exec
方案3 – Redis事务
Redis也提供了事务的概念,但它不能回滚。如果1条命令执行错误,会继续执行下面的。
multi get foo ... incr foo exec
此处的multi/extc,类似Mysql中的beganTransaction/endTransaction。
另外,由于redis是单线程的,因此事务里面的多条语句执行时,不会被打断。
Memcached的多线程 vs. Redis单线程
我们都知道, Memcached内部是多线程的,而Redis是单线程的。多线程好理解,但Redis为什么要搞成单线程呢?
个人认为,有以下几个原因:
(1)redis有各种复杂的数据结构list, has, set。也就是说,对于一个(key, value),value的类型可以是list, hash, set。在实际应用场景中,很容易出现多个客户端对同一个key的这个复杂的value数据结构进行并发操作,如果是多线程,势必要引入锁,而锁却是性能杀手。
相比较而言,memcached只有简单的get/set/add操作,没有复杂数据结构,在互斥这个问题上,没有redis那么严重。
(2)对于纯内存操作来说,cpu并不是瓶颈,瓶颈在网络IO上。所以即使单线程,也很快。另外,如果要利用多核的优势,可以在一个机器上开多个redis实例。
mysql/db | 评论:0
| Trackbacks:0
| 阅读:937
Submitted by admin on 2018, June 14, 9:20 AM
最近因为在工作中需要,学习了乐观锁与悲观锁的相关知识,这里我通过这篇文章,把我自己对这两个“锁家”兄弟理解记录下来;
- 悲观锁:正如其名,它指的是对数据被外界(包括本系统当前的其他事务,以及来自外部系统的事务处理)的修改持保守态度,因此,在整个数据处理过程中,将数据处于锁定状态。悲观锁的实现,往往依靠数据库提供的锁机制(也只有数据库层提供的锁机制才能真正保证数据访问的排他性,否则,即使在本系统中实现了加锁机制,也无法保证外部系统不会修改数据)。
以常用的mysql InnoDB存储引擎为例:加入商品表items表中有一个字段status,status=1表示该商品未被下单,status=2表示该商品已经被下单,那么我们对每个商品下单前必须确保此商品的status=1。假设有一件商品,其id为10000;如果不使用锁,那么操作方法如下:
//查出商品状态
select status from items where id=10000;
//根据商品信息生成订单
insert into orders(id,item_id) values(null,10000);
//修改商品状态为2
update Items set status=2 where id=10000;
上述场景在高并发环境下可能出现问题:
前面已经提到只有商品的status=1是才能对它进行下单操作,上面第一步操作中,查询出来的商品status为1。但是当我们执行第三步update操作的时候,有可能出现其他人先一步对商品下单把Item的status修改为2了,但是我们并不知道数据已经被修改了,这样就可能造成同一个商品被下单2次,使得数据不一致。所以说这种方式是不安全的。
使用悲观锁来实现:在上面的场景中,商品信息从查询出来到修改,中间有一个处理订单的过程,使用悲观锁的原理就是,当我们在查询出items信息后就把当前的数据锁定,直到我们修改完毕后再解锁。那么在这个过程中,因为items被锁定了,就不会出现有第三者来对其进行修改了。
注:要使用悲观锁,我们必须关闭mysql数据库的自动提交属性,因为MySQL默认使用autocommit模式,也就是说,当你执行一个更新操作后,MySQL会立刻将结果进行提交。我们可以使用命令设置MySQL为非autocommit模式:
set autocommit=0;
设置完autocommit后,我们就可以执行我们的正常业务了。具体如下:
//开始事务
begin;/begin work;/start transaction; (三者选一就可以)
//查询出商品信息
select status from items where id=10000 for update;
//根据商品信息生成订单
insert into orders (id,item_id) values (null,10000);
//修改商品status为2
update items set status=2 where id=10000;
//提交事务
commit;/commit work;
注:上面的begin/commit为事务的开始和结束,因为在前一步我们关闭了mysql的autocommit,所以需要手动控制事务的提交,在这里就不细表了。
上面的第一步我们执行了一次查询操作:select status from items where id=10000 for update;与普通查询不一样的是,我们使用了select…for update的方式,这样就通过数据库实现了悲观锁。此时在items表中,id为10000的 那条数据就被我们锁定了,其它的事务必须等本次事务提交之后才能执行。这样我们可以保证当前的数据不会被其它事务修改。
注:需要注意的是,在事务中,只有SELECT ... FOR UPDATE 或LOCK IN SHARE MODE 同一笔数据时会等待其它事务结束后才执行,一般SELECT ... 则不受此影响。拿上面的实例来说,当我执行select status from items where id=10000 for update;后。我在另外的事务中如果再次执行select status from items where id=10000 for update;则第二个事务会一直等待第一个事务的提交,此时第二个查询处于阻塞的状态,但是如果我是在第二个事务中执行select status from items where id=10000;则能正常查询出数据,不会受第一个事务的影响。
上面我们提到,使用select…for update会把数据给锁住,不过我们需要注意一些锁的级别,MySQL InnoDB默认Row-Level Lock,所以只有明确地指定主键,MySQL 才会执行Row lock (只锁住被选取的数据) ,否则MySQL 将会执行Table Lock (将整个数据表单给锁住)。除了主键外,使用索引也会影响数据库的锁定级别。
悲观锁并不是适用于任何场景,它也有它存在的一些不足,因为悲观锁大多数情况下依靠数据库的锁机制实现,以保证操作最大程度的独占性。如果加锁的时间过长,其他用户长时间无法访问,影响了程序的并发访问性,同时这样对数据库性能开销影响也很大,特别是对长事务而言,这样的开销往往无法承受。所以与悲观锁相对的,我们有了乐观锁,乐观锁的概念如下:
- 乐观锁( Optimistic Locking ) 相对悲观锁而言,乐观锁假设认为数据一般情况下不会造成冲突,所以在数据进行提交更新的时候,才会正式对数据的冲突与否进行检测,如果发现冲突了,则让返回用户错误的信息,让用户决定如何去做。那么我们如何实现乐观锁呢,一般来说有以下2种方式:
1.使用数据版本(Version)记录机制实现,这是乐观锁最常用的一种实现方式。何谓数据版本?即为数据增加一个版本标识,一般是通过为数据库表增加一个数字类型的 “version” 字段来实现。当读取数据时,将version字段的值一同读出,数据每更新一次,对此version值+1。当我们提交更新的时候,判断数据库表对应记录的当前版本信息与第一次取出来的version值进行比对,如果数据库表当前版本号与第一次取出来的version值相等,则予以更新,否则认为是过期数据。用下面的一张图来说明:

如上图所示,如果更新操作顺序执行,则数据的版本(version)依次递增,不会产生冲突。但是如果发生有不同的业务操作对同一版本的数据进行修改,那么,先提交的操作(图中B)会把数据version更新为2,当A在B之后提交更新时发现数据的version已经被修改了,那么A的更新操作会失败。
2.乐观锁定的第二种实现方式和第一种差不多,同样是在需要乐观锁控制的table中增加一个字段,名称无所谓,字段类型使用时间戳(timestamp), 和上面的version类似,也是在更新提交的时候检查当前数据库中数据的时间戳和自己更新前取到的时间戳进行对比,如果一致则OK,否则就是版本冲突。
以mysql InnoDB存储引擎为例,还是拿之前的例子商品表items表中有一个字段status,status=1表示该商品未被下单,status=2表示该商品已经被下单,那么我们对每个商品下单前必须确保此商品的status=1。假设有一件商品,其id为10000;
下单操作包括3步骤:
//查询出商品信息
select (status,version) from items where id=#{id}
//根据商品信息生成订单
//修改商品status为2
update items set status=2,version=version+1 where id=#{id} and version=#{version};
为了使用乐观锁,我们需要首先修改items表,增加一个version字段,数据默认version可设为1;
其实我们周围的很多产品都有乐观锁的使用,比如我们经常使用的分布式存储引擎XXX,XXX中存储的每个数据都有版本号,版本号在每次更新后都会递增,相应的,在XXX put接口中也有此version参数,这个参数是为了解决并发更新同一个数据而设置的,这其实就是乐观锁;
很多情况下,更新数据是先get,修改get回来的数据,然后put回系统。如果有多个客户端get到同一份数据,都对其修改并保存,那么先保存的修改就会被后到达的修改覆盖,从而导致数据一致性问题,在大部分情况下应用能够接受,但在少量特殊情况下,这个是我们不希望发生的。
比如系统中有一个值”1”, 现在A和B客户端同时都取到了这个值。之后A和B客户端都想改动这个值,假设A要改成12,B要改成13,如果不加控制的话,无论A和B谁先更新成功,它的更新都会被后到的更新覆盖。XXX引入的乐观锁机制避免了这样的问题。刚刚的例子中,假设A和B同时取到数据,当时版本号是10,A先更新,更新成功后,值为12,版本为11。当B更新的时候,由于其基于的版本号是10,此时服务器会拒绝更新,返回version error,从而避免A的更新被覆盖。B可以选择get新版本的value,然后在其基础上修改,也可以选择强行更新。
mysql/db | 评论:0
| Trackbacks:0
| 阅读:874
Submitted by admin on 2018, June 7, 10:42 AM
package main
import (
"fmt"
"regexp"
)
var reg *regexp.Regexp
var pattern string
var source string
func regexpMatch() {
// xy 匹配x y
// x|y 匹配x或者y 优先x
// source = "asdfdsxxxyyfergsfasfxyfa"
// pattern = `x|y|a`
//x* 匹配零个或者多个x,优先匹配多个
//x+ 匹配一个或者多个x,优先匹配多个
//x? 匹配零个或者一个x,优先匹配一个
//source = "xxxxewexxxasdfdsxxxyyfergsfasfxyfa"
//pattern = `x*`
// x{n,m} 匹配n个到m个x,优先匹配m个
// x{n,} 匹配n个到多个x,优先匹配更多
// x{n} 或者x{n}? 只匹配n个x
//source = "xxxxxxxewexxxasdfdsxxxyyfergsfasfxyfa"
//pattern = `x{4,}`
// x{n,m}? 匹配n个到m个x,优先匹配n个
// x{n,}? 匹配n个到多个x,优先匹配n个
// x*? 匹配零个或者多个x,优先匹配0个
// x+? 匹配一个或者多个x,优先匹配1个
// x?? 匹配零个或者一个x,优先匹配0个
//source = "xxxxxxxewexxxasdfdsxxxyyfergsfasfxyfa"
//pattern = `x??`
//[\d] 或者[^\D] 匹配数字
//[^\d]或者 [\D] 匹配非数字
//source = "xx435ff5237yy6346fergsfasfxyfa"
//pattern = `[\d]{3,}` //匹配3个或者更多个数字
//source = "xx435ffGUTEYgjk52RYPHFY37yy6346ferg6987sfasfxyfa"
//pattern = `[a-z]{3,}` //三个或者多个小写字母
//source = "xx435ffGUTEYgjk52RYPHFY37yy6346ferg6987sfasfxyfa"
//pattern = `[[:alpha:]]{5,}` //5个或者多个字母,相当于A-Za-z
//source = "xx435,./$%(*(_&jgshgs发个^$%ffG返回福hjh放假啊啥UTEYgjk52RYPHFY37yy6346ferg6987sfasfxyfa"
//pattern = `[\p{Han}]+` //匹配连续的汉字
//source = "13244820821HG74892109977HJA15200806084S11233240697hdgsfhah假发发货"
//pattern = `1[3|5|7|8|][\d]{9}` //匹配电话号码
//source = "132@12.comGKGk15@163.cn200806084S11233240697hdgsfhah假发发货"
//pattern = `\w+([-+.]\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)*` //匹配电子邮箱
//匹配用户名或者密码 `^[a-zA-Z0-9_-]{4,16}$` 字母或者数字开头,区分大小写,最短4位最长16位
//匹配IP地址1 `^$(?:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\.){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)$`
//匹配IP地址2
//pattern = `((2[0-4]\d|25[0-5]|[01]?\d\d?)\.){3}(2[0-4]\d|25[0-5]|[01]?\d\d?)`
//匹配日期 年-月-日 `(\d{4}|\d{2})-((1[0-2])|(0?[1-9]))-(([12][0-9])|(3[01])|(0?[1-9]))`
//匹配日期 月-日-年 `((1[0-2])|(0?[1-9]))/(([12][0-9])|(3[01])|(0?[1-9]))/(\d{4}|\d{2})`
//匹配时间 小时:分钟 24小时制 ` ((1|0?)[0-9]|2[0-3]):([0-5][0-9]) `
//匹配邮编 `[1-9][\d]5`
//匹配URL `[a-zA-z]+://[^\s]*`
reg = regexp.MustCompile(pattern)
fmt.Printf("%s", reg.FindAllString(source, -1))
}
func main() {
regexpMatch()
}
golang | 评论:0
| Trackbacks:0
| 阅读:776
Submitted by admin on 2018, June 6, 11:58 PM
- // 中国大陆手机号码正则匹配, 不是那么太精细
- // 只要是 13,14,15,18 开头的 11 位数字就认为是中国手机号
- chinaMobilePattern = `^1[3458][0-9]{9}$`
- // 用户昵称的正则匹配, 合法的字符有 0-9, A-Z, a-z, _, 汉字
- // 字符 '_' 只能出现在中间且不能重复, 如 "__"
- nicknamePattern = `^[a-z0-9A-Z\p{Han}]+(_[a-z0-9A-Z\p{Han}]+)*$`
- // 用户名的正则匹配, 合法的字符有 0-9, A-Z, a-z, _
- // 第一个字母不能为 _, 0-9
- // 最后一个字母不能为 _, 且 _ 不能连续
- namePattern = `^[a-zA-Z][a-z0-9A-Z]*(_[a-z0-9A-Z]+)*$`
- // 电子邮箱的正则匹配, 考虑到各个网站的 mail 要求不一样, 这里匹配比较宽松
- // 邮箱用户名可以包含 0-9, A-Z, a-z, -, _, .
- // 开头字母不能是 -, _, .
- // 结尾字母不能是 -, _, .
- // -, _, . 这三个连接字母任意两个不能连续, 如不能出现 --, __, .., -_, -., _.
- // 邮箱的域名可以包含 0-9, A-Z, a-z, -
- // 连接字符 - 只能出现在中间, 不能连续, 如不能 --
- // 支持多级域名, x@y.z, x@y.z.w, x@x.y.z.w.e
- mailPattern = `^[a-z0-9A-Z]+([\-_\.][a-z0-9A-Z]+)*@([a-z0-9A-Z]+(-[a-z0-9A-Z]+)*\.)+[a-zA-Z]+$`
golang | 评论:0
| Trackbacks:0
| 阅读:954
Submitted by admin on 2018, June 6, 11:30 PM
密码:必须含有数字和字母,可以拥有英文符号,6-17位。正则表达式怎么写?
if(!preg_match('/(?=^.*?[a-z])(?=^.*?[A-Z])(?=^.*?\d)^(.{6,17})$/','151523152f4545242')){
echo '密码不符合规定!';
}
/(?=^.*?[a-z])(?=^.*?[A-Z])(?=^.*?\d)^(.{6,17})$/
要求至少有一个大写字母
而 151523152f4545242 中并没有!
必须且只含有数字和字母,可以拥有英文符号,6-17位。
/(?=.{6,17})(?=.*\d)(?=.*[a-z])[\x20-\x7f]*/i
if(!preg_match('/(?=^.*?[a-z])(?=^.*?[A-Z])(?=^.*?\d)^(.{6,17})$/','15A15545242')){
echo '密码不符合规定!';
}
php | 评论:0
| Trackbacks:0
| 阅读:806
Submitted by admin on 2018, June 5, 11:41 AM
package main
import (
"encoding/json"
"fmt"
"os"
)
type ConfigStruct struct {
Host string `json:"host"`
Port int `json:"port"`
AnalyticsFile string `json:"analytics_file"`
StaticFileVersion int `json:"static_file_version"`
StaticDir string `json:"static_dir"`
TemplatesDir string `json:"templates_dir"`
SerTcpSocketHost string `json:"serTcpSocketHost"`
SerTcpSocketPort int `json:"serTcpSocketPort"`
Fruits []string `json:"fruits"`
}
type Other struct {
SerTcpSocketHost string `json:"serTcpSocketHost"`
SerTcpSocketPort int `json:"serTcpSocketPort"`
Fruits []string `json:"fruits"`
}
func main() {
jsonStr := `{"host": "http://localhost:9090","port": 9090,"analytics_file": "","static_file_version": 1,"static_dir": "E:/Project/goTest/src/","templates_dir": "E:/Project/goTest/src/templates/","serTcpSocketHost": ":12340","serTcpSocketPort": 12340,"fruits": ["apple", "peach"]}`
//json str 转map
var dat map[string]interface{}
if err := json.Unmarshal([]byte(jsonStr), &dat); err == nil {
fmt.Println("==============json str 转map=======================")
fmt.Println(dat)
fmt.Println(dat["host"])
}
//json str 转struct
var config ConfigStruct
if err := json.Unmarshal([]byte(jsonStr), &config); err == nil {
fmt.Println("================json str 转struct==")
fmt.Println(config)
fmt.Println(config.Host)
}
//json str 转struct(部份字段)
var part Other
if err := json.Unmarshal([]byte(jsonStr), &part); err == nil {
fmt.Println("================json str 转struct==")
fmt.Println(part)
fmt.Println(part.SerTcpSocketPort)
}
//struct 到json str
if b, err := json.Marshal(config); err == nil {
fmt.Println("================struct 到json str==")
fmt.Println(string(b))
}
//map 到json str
fmt.Println("================map 到json str=====================")
enc := json.NewEncoder(os.Stdout)
enc.Encode(dat)
//array 到 json str
arr := []string{"hello", "apple", "python", "golang", "base", "peach", "pear"}
lang, err := json.Marshal(arr)
if err == nil {
fmt.Println("================array 到 json str==")
fmt.Println(string(lang))
}
//json 到 []string
var wo []string
if err := json.Unmarshal(lang, &wo); err == nil {
fmt.Println("================json 到 []string==")
fmt.Println(wo)
}
}
golang | 评论:0
| Trackbacks:0
| 阅读:864
Submitted by admin on 2018, April 19, 12:36 AM
设置root密码
sudo passwd
1、vi /etc/network/interfaces
添加内容:
auto eth0
iface eth0 inet static
address 192.168.8.100
netmask 255.255.255.0
gateway 192.168.8.2
dns-nameserver 119.29.29.29
vim /etc/ssh/sshd_config
- #PermitRootLogin without-password
- PermitRootLogin yes
killall命令
apt-get install psmisc
ubuntu | 评论:0
| Trackbacks:0
| 阅读:894
Submitted by admin on 2018, April 17, 6:06 PM
文件下载之断点续传(客户端与服务端的实现)
https://www.cnblogs.com/zhaopei/p/download.html
文件各种上传,离不开的表单
http://www.cnblogs.com/zhaopei/p/upload.html
Golang实现断点续传
https://www.cnblogs.com/7explore-share/p/8111720.html
阿里云上传文件
https://helpcdn.aliyun.com/document_detail/32147.html
Go语言实现文件断点续传功能—resumable file uploads
HTTP 断点续传(分块传输)
https://blog.csdn.net/liang19890820/article/details/53215087
HTTP Range 请求
HTTP Range请求允许服务器向客户端发送HTTP消息体的一部分数据。Partial Requests在使用比较大的网络媒体文件或者在下载文件时提供暂停和恢复功能时很有用。
这也是下载时实现HTTP断点续传的一个关键。
HTTP 206 (Partial Content)
如果服务器能返回HTTP 206请求,我们就知道它能够支持Range request.
# curl -I https://www.baidu.com/ -H "Range: bytes=0-"
下载续传,一般WEB服务器,如nginx,apache,iis已支付,只在客户端实现即可
上传续传,也叫分片上传,需要分别在服务端,客户端实现
服务端针对分片的处理,获取当前的分片,每个分片上传保存,然后将分片合并
---
一些思路
提供一个思路,上传前先往数据库插入一条数据。数据包含文件要存的路径、文件名(用GUID命名,防止同名文件冲突)、文件MD5(用来识别下次续传和秒传)、临时文件块存放路径、文件是否完整上传成功等信息。
然后如果我们断网后再传,首先获取文件MD5值,看数据库里面有没上传完成的文件,如果有就实现秒传。如果没有,看是不是有上传了部分的。如果有接着传,如果没有则重新传一个新的文件。
golang | 评论:0
| Trackbacks:0
| 阅读:920
